修复 Sovereign 无法访问网站时的网页研究受阻问题
如何解决导致你的 Sovereign 无法搜索网页、抓取页面和提取数据的 IP 屏蔽问题——使用 Firecrawl Cloud API。
如果你的 Sovereign 在执行网页搜索、抓取页面或从网站提取数据时遇到困难,可能是因为你的 Sovereign Brain 的公共 IP 地址被反机器人系统标记了。这种情况往往发生在执行大量网页研究的设备上。本文介绍如何识别问题并让研究功能恢复正常。
症状
如果你同时注意到以下几种情况,就可能遇到了这个问题:
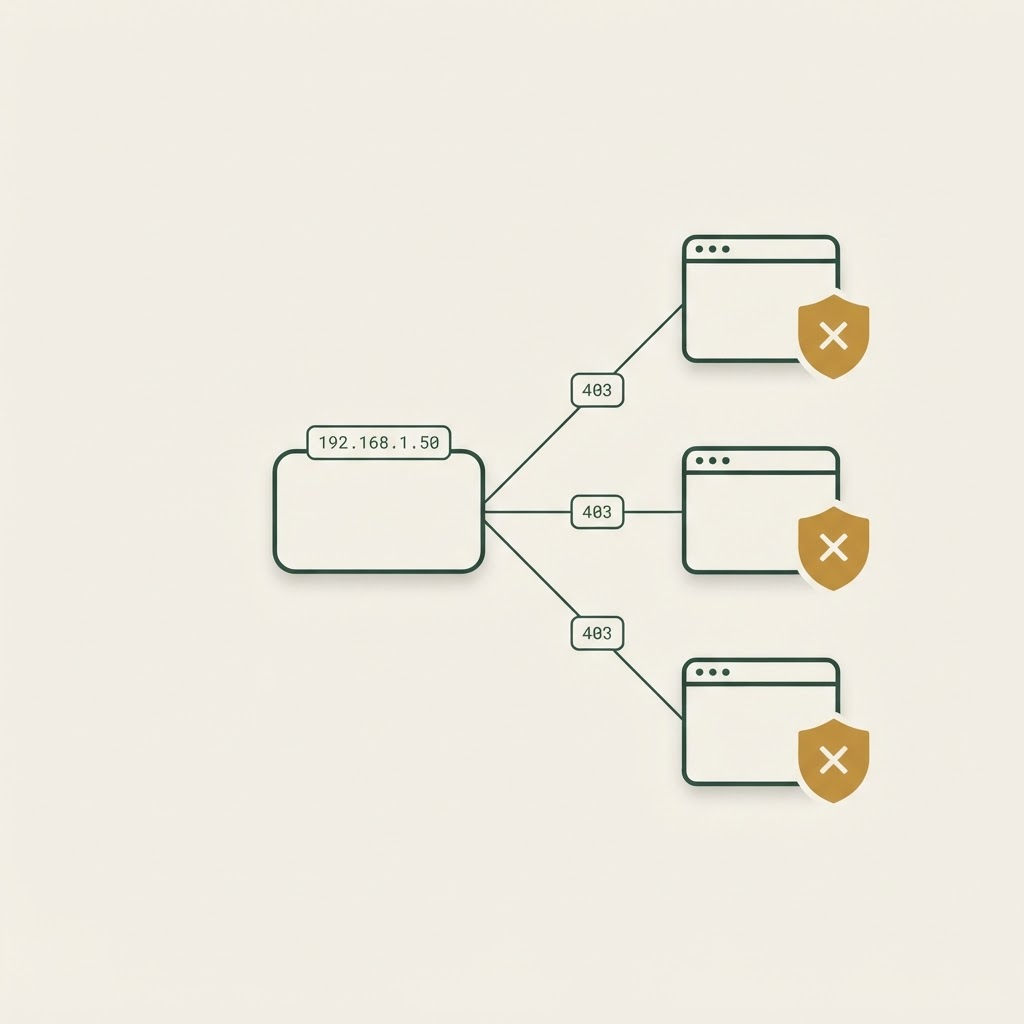
- Google 和 Bing 等搜索引擎不返回结果或被屏蔽
- SEC EDGAR 等网站返回 403 错误
- LinkedIn、受 Cloudflare 保护的网站以及许多公司网站无法加载
- Brave Search 返回损坏或不可用的结果
- 大多数网页提取尝试失败
Note
某些直接的网站连接可能偶尔仍然可用,但你的 Sovereign 的整体研究能力会明显下降。
原因
这是因为你的 Sovereign Brain 的出站 IP 地址被安全系统标记为可疑或机器人相关流量。一旦 IP 被标记,许多主要网站和服务就会开始屏蔽或限制来自该地址的访问——无论你的 Sovereign 实际在做什么。
解决方案:使用 Firecrawl Cloud API
如果你的 Sovereign 受到 IP 屏蔽影响,最有效的即时修复是让它使用 Firecrawl Cloud API 进行研究,而不是依赖直接的浏览器或搜索工具。Firecrawl 从自己的基础设施发起连接,因此被标记的 IP 不再成为障碍。
步骤 1:创建 Firecrawl 账户
- 访问 firecrawl.dev。
- 注册一个账户——提供免费套餐。
- 验证你的电子邮件地址。
步骤 2:生成你的 API 密钥
- 登录 Firecrawl 仪表板。
- 进入 API Keys(通常在 Settings 下)。
- 点按 Create API Key。
- 立即复制密钥——它只显示一次。
Warning
请像对待密码一样对待你的 API 密钥。不要把它粘贴到共享文档或公共聊天中;如果你认为它已经泄露,请生成一个新密钥。
步骤 3:在你的 Sovereign Brain 上添加密钥
与你的 Sovereign 开始对话并给出如下指令,或者如果你的大脑提供了管理界面,也可以通过它添加密钥:
From now on, use the Firecrawl Cloud API for all web research and scraping tasks.
Use this API key: [INSERT YOUR API KEY HERE]
Please switch to Firecrawl's scrape_url or crawl_url functions instead of the
direct browser tools or search engines.
步骤 4:测试
请你的 Sovereign 在之前被屏蔽的网站上运行一次测试抓取——投资者关系页面或 SEC 文件就很合适——并确认它现在可以返回干净、可用的数据。
确认生效
配置完成后,你的 Sovereign 应该能够完成之前被屏蔽的研究任务,包括提取联系信息和浏览受保护的网站。如果某个任务仍然失败,请明确要求你的 Sovereign 通过 Firecrawl 重试,因为它可能仍在默认使用直接工具。
其他解决方案
Firecrawl 是最快的修复方式,但根据你的情况,还有几种其他方法可能有帮助。
| 解决方案 | 最适合的情况 | 说明 |
|---|---|---|
| 住宅代理服务 | 研究量大 | 需要额外设置 |
| 自托管 Firecrawl | 你希望完全掌控 | 维护更复杂 |
| 多台 Sovereign Brain | 运行多台 Centurion | 有助于分散研究负载 |
建议
- 对于任何经常执行研究的 Sovereign,将 Firecrawl 作为主要的网页工具。
- 留意研究成功率,如果屏蔽症状再次出现,请重新阅读本文。
- 对于研究量大的实例,可以考虑逐步采用专用出口节点或代理。
Tip
如果网页研究只是偶尔失败,那可能是临时网络问题,而不是 IP 屏蔽。在设置 Firecrawl 之前,先检查 Connection timed out。
这篇文章对你有帮助吗?